


Depuis quelques semaines, on voit fleurir des posts et des articles sur « l’importance des auteurs » en SEO, dans Discover, dans les réponses IA. Tant mieux. Mais la plupart en parlent comme d’un signal de réassurance : une byline, une page auteur, un peu de schema, et hop, de l’E-E-A-T.
L’auteur est une entité du Knowledge Graph : un identifiant, des relations, un historique, des profils sociaux reliés. Une brique structurelle du système, présente sur toutes les surfaces de Google : Search, Discover, News, Maps, et maintenant les réponses génératives.
On le montre, data à l’appui, depuis mars 2025. Voici les preuves, les dates, et les nuances qui vont avec.
Le mythe : l’auteur comme case à cocher
La version courante du conseil « auteurs » ressemble à ceci : ajoutez une byline, créez une page auteur, balisez avec schema.org/author, liez vos réseaux sociaux. C’est de l’hygiène éditoriale, et ce n’est pas inutile.
Tout cela décrit ce que vous déclarez. Google, lui, construit un profil d’entité, que vous l’aidiez ou non, à partir de tout ce que la machine peut lire : vos articles, vos profils sociaux personnels, les mentions par des tiers, les co-occurrences avec d’autres entités.
Quelle entité Google a-t-il construite pour votre meilleur auteur, et tient-elle debout ?
Marseille, mars 2025 : « un auteur ? une entité »
Le 27 mars 2025, au salon FePSeM à Marseille, nous présentions avec Damien Andell « Entities everywhere » : deux mois de feed Discover décortiqués, 500 000 articles, 65 000 entités extraites à l’époque (depuis on a fait mieux :D). La version écrite est en ligne depuis juillet 2025 : Conf de Marseille Entities Everywhere : les entités sur Discover et un papier co-écrit avec Olivier de Segonzac : Entities Everywhere : le Knowledge Graph, architecture invisible de l’empire Google.
Dans le lot, une slide tenait en quatre mots :
Un auteur ? Une entité.
L’exemple : une autrice de CuisineAZ. Sur ses articles Discover, on trouvait une entité que l’API Knowledge Graph de Google refuse de donner. Une entité bien réelle pourtant, avec ses profils de réseaux sociaux associés. Et pas ceux du site : les siens, personnels.
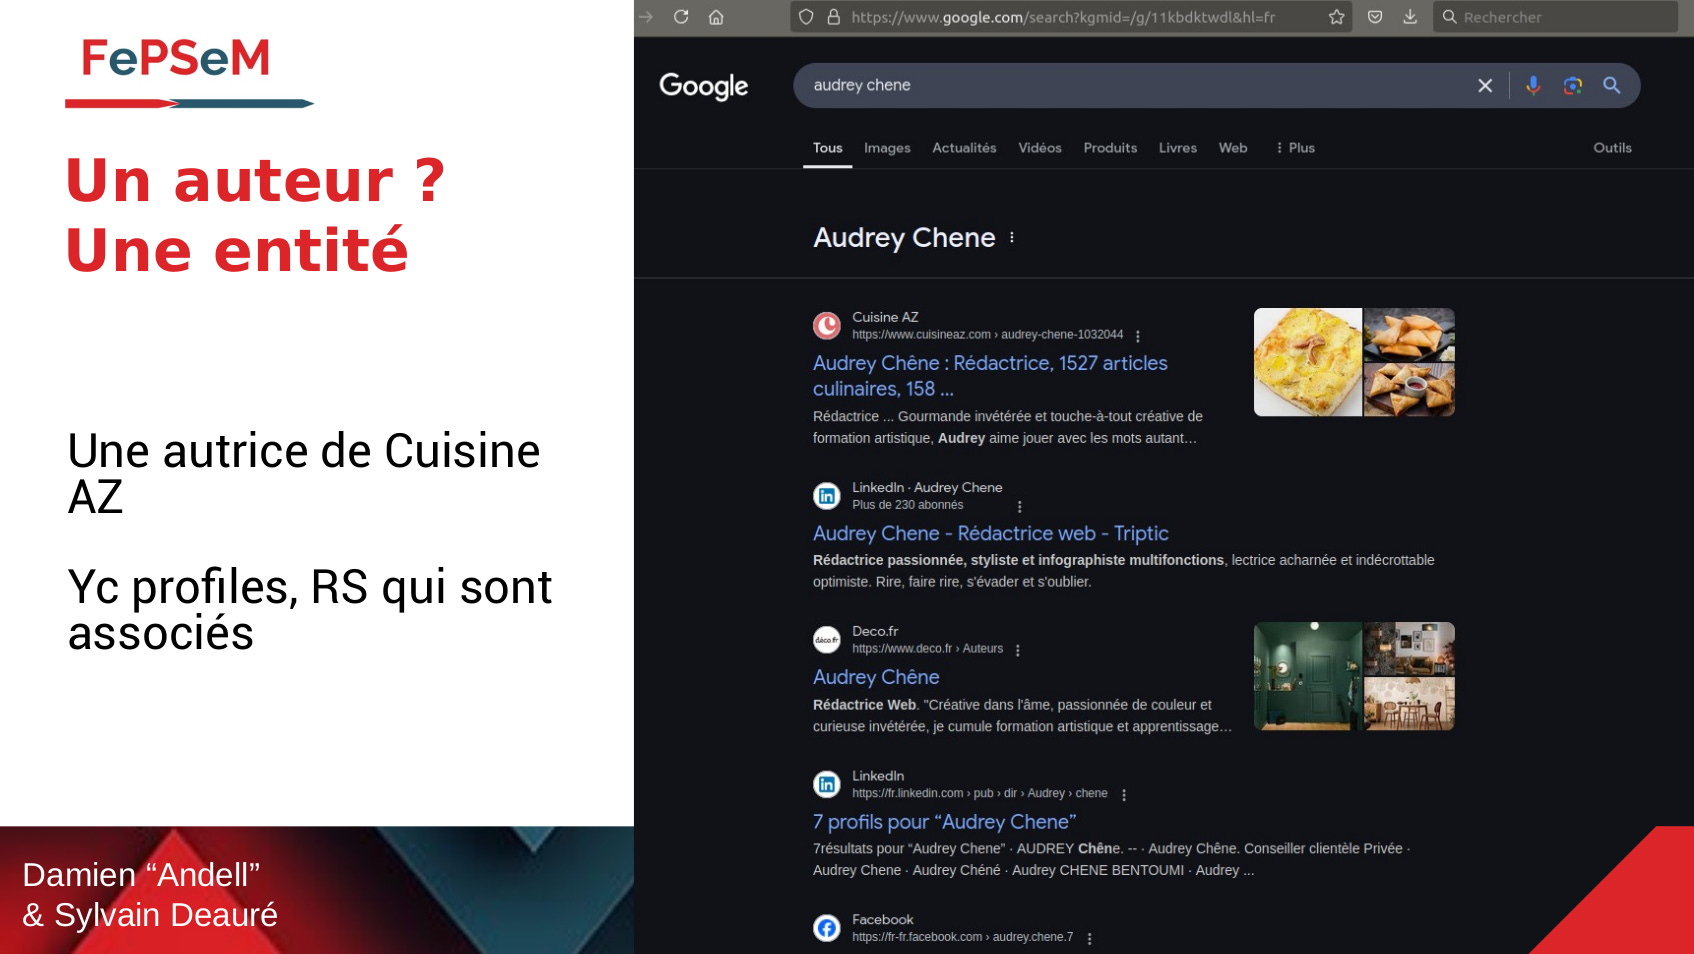
Autrement dit : Google avait relié la personne à ses comptes personnels, distingué l’autrice du média qui l’emploie, et attaché cette entité aux articles qu’elle signe. Google sait relier les points.
Deuxième démonstration, le suivi à la trace : sur Google News, la page auteur de cette même autrice est vide en apparence. Mais les données obfusquées de la page permettent de remonter directement à son identifiant Knowledge Graph. La même entité, d’un service à l’autre : ces entités sont communes à tous les services Google.
Le cas est représentatif. Des entités visibles côté Discover et absentes de l’API publique, on en croise en permanence : sur notre corpus de l’époque, la répartition des entités du feed donnait 60 % résolues via Wikidata, 26 % via l’API Knowledge Graph publique, et 11 % « inconnues » des sources publiques. Des sites, des produits... et des auteurs.
C’est un sujet qu’on a décortiqué ailleurs, notamment dans Knowledge Graph : le moteur caché derrière l’IA de Google sur Abondance, et dans « et si Google ne nous disait pas tout ? » pour Réacteur. Google maintient des entités que personne ne peut requêter de l’extérieur, et l’API publique n’ouvre qu’une fenêtre étroite sur le graphe réel.
Les traces système, nommées dans le code
Depuis Marseille, trois familles de preuves techniques se sont accumulées.
Dans Discover. Les entités du Knowledge Graph sont omniprésentes, nous les captons et les analysons. La personnalisation de votre feed passe par les entités que vous suivez, dont les médias, et les auteurs avec lesquels vous avez une affinité.
Dans les brevets. Le brevet WO2025063948A1 décrit la construction d’un profil holistique d’entité (entreprise, marque... ou personne) par interprétation de tout ce qui est lisible, plutôt que par extraction de ce qui est déclaré. Le balisage aide ; l’interprétation se passe de lui.
Dans Maps, le plus récent. L’étude de Resoneo « Google Map disséqué » (août 2026) expose la brique Webref, qui décide de quelle entité parle une page, à quel point, avec quelle confiance : normalizedTopicality, connectedness, relevanceScore... et des flags explicites : isAuthor, isPublisher, isReferencePage.
Relisez ce flag. Dans l’infrastructure qui relie le web aux entités, « est-ce que cette page est celle de l’auteur ? » est une question que le système se pose littéralement, champ nommé à l’appui. Dans les protos de Google, l’auteur est un booléen.
Search profiles : Google officialise sa couche d’identité
Google a fini par assumer publiquement cette mécanique, et nous en avons documenté la construction pièce par pièce, avant chaque annonce officielle.
Le fil est parti d’un message de Damien Andell, un mercredi soir de mars 2025 : le bouton Follow de Chrome crée une entité pour chaque site. On tire dessus depuis dix-huit mois.
Et ce chantier ne date pas de l’IA. Il ne date même pas de 2011.
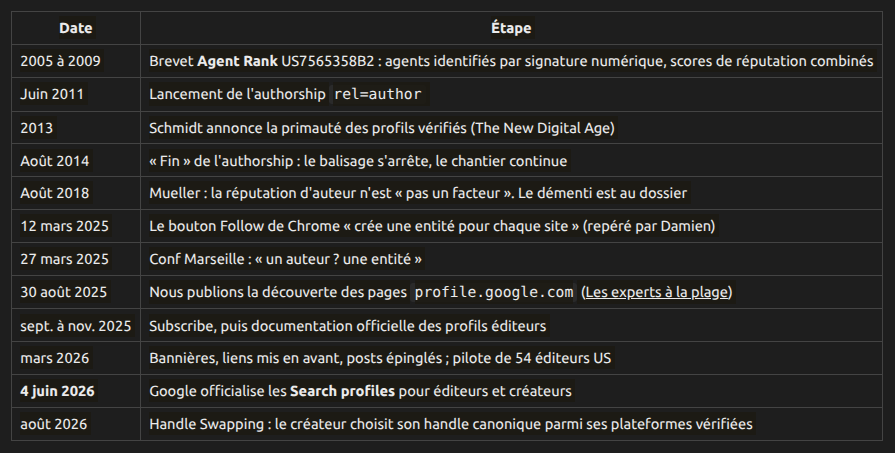
En 2005, Google dépose un brevet intitulé Agent Rank (US7565358B2, accordé en 2009). Le principe : des « agents » (auteurs, éditeurs, commentateurs) identifiés par signature numérique, et des contenus classés selon les scores de réputation combinés des agents qui les signent. Autrement dit, il y a vingt ans, Google écrivait noir sur blanc que l’identité d’un contributeur pouvait être une déclaration signée, vérifiable, et qu’elle pouvait peser sur le classement. C’est très exactement ce que nous formulions en août 2026 à propos du Handle Swapping : l’identité doit être une déclaration, pas une déduction. Le brevet avait vingt ans d’avance sur la formule.
Vient ensuite l’authorship (rel=author), lancée en juin 2011. En 2013, Eric Schmidt et Jared Cohen écrivaient dans The New Digital Age (p. 33) :
« Imagine all of your accounts — Facebook, Twitter, Skype, Google+, Netflix, New York Times subscription — linked to an “official profile.” Within search results, information tied to verified online profiles will be ranked higher than content without such verification, which will result in most users naturally clicking on the top (verified) results. The true cost of remaining anonymous, then, might be irrelevance. »
Avec les yeux de 2026, la première phrase décrit des comptes multi-plateformes liés à un profil officiel, et le vérifié qui classe au-dessus du reste. C’est la description des Search profiles, écrite douze ans avant leur lancement, jusqu’au choix du compte canonique. À l’époque, les SEOs y ont lu l’annonce d’un « Author Rank », Google a démenti, Danny Sullivan a rappelé qu’il s’agissait d’une prédiction dans un chapitre sur l’identité et pas d’une annonce produit, et tout le monde a rangé la citation. La prédiction était juste ; c’est le calendrier que personne n’a cru. Quant à l’authorship, « arrêté » en août 2014 : c’est le balisage qui a été rangé, pas le concept : l’entité auteur a continué à se construire en dessous, et c’est elle que nous observons depuis 2025.
Un démenti manque encore au dossier : après le core update d’août 2018, John Mueller a déclaré que Google n’utilisait pas la réputation individuelle d’un auteur comme facteur de classement. Peut-être, mais le chantier entité, lui, n’a jamais cessé, et les traces système décrites plus haut portent des noms.
Chronologie courte :
Notre monitoring régulier suit aujourd’hui environ 47 000 profils dans 7 langues. Ce qu’on y lit est cohérent avec tout ce qui précède : Google construit une couche d’identité pour les personnes et les sources, avec knowledge panel, bouton Follow, statistiques, et depuis peu le choix du handle. Notre formule au moment du Handle Swapping résume l’enjeu : l’identité doit être une déclaration, pas une déduction statistique. Google outille les créateurs parce qu’il en a besoin : pour ancrer les entités, et pour tracer l’autorité et le reach d’un auteur à travers les plateformes.
Le marché arrive aux mêmes conclusions. Moz écrivait en juillet 2026 :
« The unit of authority is migrating from the domain to the individual. »
Nous sommes d’accord. On le disait depuis un an.
Les Google Search profiles sont la dernière brique visible de ce système, le petit « plus » humain qui permet aux créateurs, à partir d’une certaine audience, d’avoir un contrôle minimal sur leur profil, leur knowledge panel, leurs réseaux sociaux de référence, leur handle public chez Google.
Ce profil est plus important qu’il n’y paraît.
« Et si je n’ai pas assez d’abonnés ? »
La question nous a été posée telle quelle par un client, il y a quelques jours :
Peut-on obtenir les manettes de son Search profile sans atteindre le minimum d’abonnés exigé par Google ?
Le profil n’attend pas votre permission pour exister. Google le génère automatiquement, à partir du knowledge graph et de ce qu’il a réussi à relier autour de vous. Le seuil d’abonnés conditionne la revendication, pas la création : le droit de vous asseoir au volant d’une fiche qui roule déjà.
La couche produit obéit donc à la même logique que la couche entité : Google construit d’abord, vous donne la main ensuite, et pas à tout le monde.
Ces seuils, fixés haut au lancement, ont déjà été abaissés deux fois:
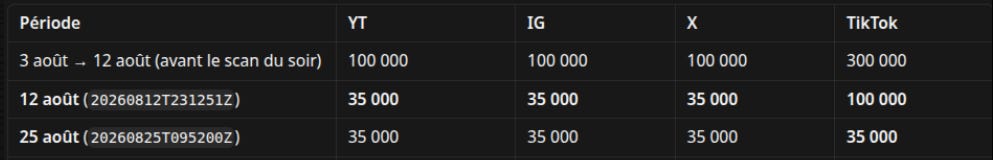
La trajectoire compte plus que le palier du jour : Google ouvre progressivement le volant à des audiences plus petites, ce qui est cohérent avec un chantier d’identité qu’il a intérêt à généraliser.
À ce client, on a répondu deux choses.
Ne cherchez pas à truander cet aspect. Bien que ce ne soit pas garanti, on peut espérer que les seuils continuent de baisser.
Par contre, prenez le signal pour ce qu’il est. En adossant l’accès à son propre outil d’identité au poids de vos comptes sociaux, Google dit à quel point ces comptes comptent dans sa lecture de votre crédibilité. C’est l’aveu le plus direct qu’il ait fait sur le sujet. Donc mettez le paquet pour faire grossir ces réseaux, de la manière la plus organique possible. C’est vrai pour le seuil ; c’est surtout vrai pour l’entité, qui, elle, n’attend pas 2026 pour se construire.
Être une entité et avoir un Search profile sont deux choses différentes. L’autrice de CuisineAZ que nous montrions en mars 2025 était déjà une entité pleine et entière, reliée à ses comptes personnels, des années avant qu’un seuil d’abonnés n’existe. Le seuil garde une interface ; le Knowledge Graph, lui, est déjà servi.
Revendiquer son profil, et voir bouger son knowledge panel
Ceux qui ont franchi le seuil et revendiqué leur profil découvrent ensuite quelque chose que peu avaient anticipé.
Ce qu’ils éditent dans leur profil, à commencer par leur description, se retrouve dans leur knowledge panel. Suggérer des modifications à son knowledge panel après l’avoir revendiqué, c’était déjà possible, la mécanique existe depuis des années. Ici le trajet est direct : on édite, ça passe.
Le second effet a surpris davantage. Des créateurs qui n’avaient pas de knowledge panel en voient apparaître un. Une recherche sur leur nom, et mieux encore sur leur handle, celui qu’ils viennent justement de choisir, ramène un panneau sur mobile là où il n’y avait rien.
Damien, qui décortique ces pages depuis des mois, n’a pas été surpris une seconde :
Ben oui.
La revendication crée un identifiant d’entité dédié, et le profil sert ensuite de source pour peupler le panneau. Évident quand on a passé un an et demi dedans. Moins pour tout le monde.
Un exemple ici avec une requête “Barry Schwartz” sur mobile, qui montre le bouton “follow” mais aussi directement un bouton “View Search Profile” et liste les profiles de Barry, comme il les a lié dans son profile.
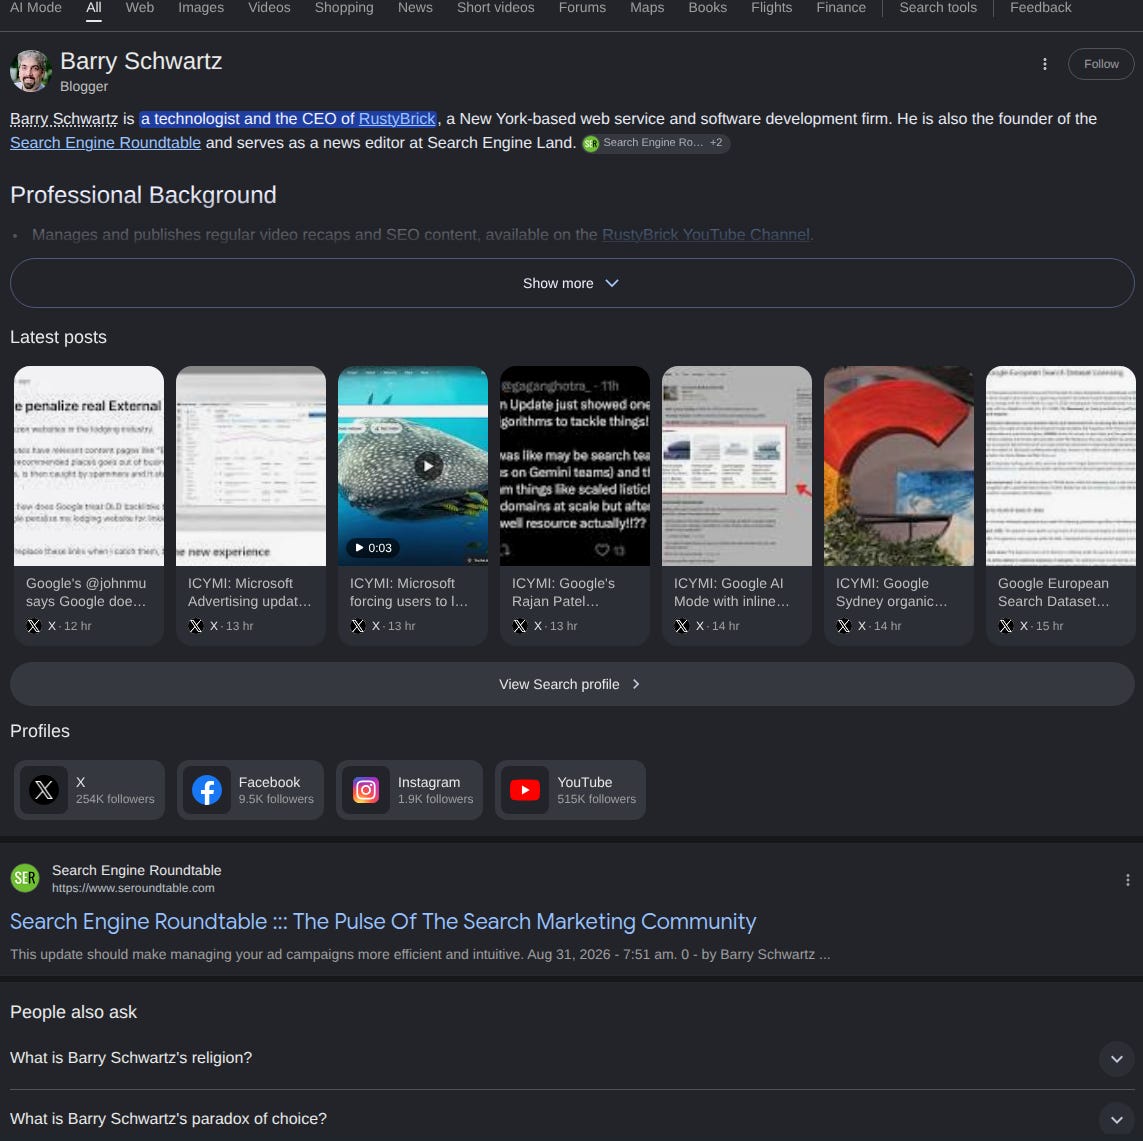
Un créateur qui revendique son profile et l’édite écrit donc dans le Knowledge Graph de Google. Le profil est une porte d’entrée dans le graphe, et cela vaut dans les deux sens : l’entité existe avant lui, et lui la nourrit, la fortifie et la désambiguïse ensuite.
Le multiplicateur et ses limites
Attention au balancier inverse. « Les auteurs comptent » ne veut pas dire « pas d’auteur, pas de visibilité ». Notre data est claire là-dessus, et on le dit depuis Marseille :
On peut entrer et performer sur Discover sans auteur, voire avec des auteurs bidons. On observe des sites qui cochent zéro case (pas de mentions, pas d’auteur identifié, pas de sitemap) et qui cartonnent, portés par la qualité de leurs interactions sociales.
Détail savoureux : certains faux auteurs ont un identifiant Knowledge Graph, comme les vrais. Créer l’entité ne suffit pas ; c’est sa cohérence et son historique qui portent.
À l’inverse, les auteurs trop prolixes sont un signal qui se retourne : une même signature qui touche à tout, sans existence ni activité sociale, c’est le motif classique des sites full IA et des vendeurs de liens. Google relie les points là aussi.
Un auteur avec une expertise précise, des mentions, une activité sociale réelle donne un gros boost à ses articles et au site pour lequel il écrit. C’est le pattern que nos données montrent, article après article.
Un auteur crédible est donc un multiplicateur ; l’entrée, elle, reste ouverte sans lui. Si quelqu’un vous vend « l’entité auteur » comme le nouveau levier magique, gardez la main sur la barre : c’est une brique du Knowledge Graph parmi d’autres, à côté des marques, des sites, des produits et des lieux, des sujets traités, le tout devant être cohérent, yc là où c’est hors de votre contrôle direct.
Trois questions à poser sur vos auteurs
Google a-t-il construit quelque chose de cohérent à leur sujet ? Au-delà de la page auteur : est-ce que leurs profils sociaux personnels, leurs mentions et leur historique de publication racontent la même histoire ?
Cette histoire est-elle cohérente PARTOUT ? L’entité auteur vit sur toutes les surfaces : la byline de vos articles, la page News, le Search profile, les réseaux, les mentions tierces. Les incohérences se voient, puisque c’est la même entité qui circule de service en service.
L’expertise déclarée correspond-elle au territoire couvert ? Un auteur qui signe dans son domaine accumule ; un auteur qui signe tout dilue, voire alerte.
Plus tard, nous creuserons probablement chaque pièce du dossier : les traces système en détail, les faux auteurs, les Search profiles, et la place de l’auteur dans le web d’entités qui se construit sous nos yeux. L’auteur n’est qu’un nœud de ce réseau ; c’est la cohérence de l’ensemble qui fait la différence.
D’ici là, une question de vigie : si Google construisait aujourd’hui l’entité de votre meilleur auteur, uniquement à partir de ce qui est lisible en ligne... seriez-vous à l’aise avec le résultat ?
